

Yapay zekâ pilotları alkış topluyor, grafikler yukarı tırmanıyor. Peki kazanılan o zaman, o kapasite, gerçekte kimin bütçesinde duruyor?
Şu sahneyi hepimiz bir yerlerden biliriz … Yönetim kurulu salonu, ışıklar kısık, ekranda yedinci pilotun demosu dönüyor. Üç farklı iş biriminde üretken yapay zekâ kullanılıyor, slaytta yukarı tırmanan verimlilik grafikleri var, köşede de “potansiyel tasarruf” yazan kocaman bir sayı. Sunumu yapan biraz gururlu, biraz tedirgin, salon kibarca alkışlıyor. Sonra CFO parmağını kaldırıp sakin bir sesle soruyor: “Bu, hangi kalemde görünecek?” İşte o sessizlik var ya, bu yazı işte tam o sessizliğin içinde.
Sahne kurgu elbette, ama sessizlik kurgu değil. McKinsey’nin 2025 araştırmasında katılımcıların yüzde 39’u yapay zekânın faiz ve vergi öncesi kâra (EBIT) herhangi bir düzeyde katkı yaptığını söylüyordu, bunların çoğu da etkinin yüzde 5’in altında kaldığını belirtiyordu. Kullanım hızla yayılıyor, kâr-zarar tablosuna yansıması çok daha yavaş ve düzensiz.
Bence bunun nedenini teknolojide aramak yanlış. Birden çok şirketi olan bir yapıda yapay zekâ dönüşümü, bir teknoloji işi olmaktan çok bir portföy ve hesap verebilirlik işi. Daha doğrusu üç işin aynı anda yapılması: neye yatırım yapacağını seçmek, çıkan teknik kazanımı finansal ve operasyonel değere çevirmek, bir de insanların, süreçlerin ve karar mekanizmalarının gerçekten değişmesini sağlamak. Üçünden biri eksik kalınca diğer ikisi de sonuç üretmiyor. Çünkü çok iyi çalışan bir uygulama yazıp iş sürecini değiştirmezseniz, kazanılan kapasiteyi de başka bir işe yönlendirmezseniz. Yaptığınız şey mevcut sürecin bir parçasını hızlandırmaktan öteye geçmez.
Başlığı da baştan açıklayayım, yoksa iktisatçılar kızar. Her tasarruf bilançoya düşmez. Bir kısmı gelir tablosunda görünür, bir kısmı bütçede, bir kısmı da hiçbir yere yazılmayan, yalnızca “kazanılmış kapasite” olarak havada asılı kalan bir şeydir. Mesele zaten bu farkı kimsenin yüksek sesle söylememesi.
Pilot arafı
Rakamlarla başlayalım, çünkü üç “başarısızlık” rakamı çokça konuşuluyor. Ve üçü de hep aynı torbaya atılıyor. Gartner’ın Temmuz 2024 tahmini, üretken yapay zekâ projelerinin en az yüzde 30’unun 2025 sonuna kadar kanıt aşamasından sonra terk edileceğini söylüyor. Bu bir tahmin, ölçüm değil. S&P Global’in 2025 anketi ise bir yoklama: şirketlerin yüzde 42’si yapay zekâ inisiyatiflerinin çoğunu bırakmış, bir yıl önce bu oran yüzde 17’ymiş, ortalama bir kurum da kanıt aşamasındaki çalışmaların yüzde 46’sını üretime çıkarmadan rafa kaldırmış. Üçüncüsü hepimizin aklındaki yüzde 95. MIT’nin NANDA girişiminin 2025 raporu, entegre pilotların yalnızca yüzde 5’inin büyük değer çıkardığını, geri kalanında ölçülebilir bir kâr-zarar etkisi görülmediğini söylüyor. Rakamının nasıl hesaplandığı da yeterince açıklanmadığı için eleştirileri üzerine çekti.
Üç rakam, üç ayrı şey. Biri terk edilmeyi tahmin ediyor, biri bırakılan inisiyatifleri soruyor, biri kâr-zarar etkisinin yokluğunu iddia ediyor. “Yapay zekâ projelerinin yüzde 95’i başarısız” cümlesi bunların hiçbirini doğru anlatmıyor. Ajan tarafında da hikâye benzer: Gartner, 2027 sonuna kadar ajan projelerinin yüzde 40’ından fazlasının iptal edileceğini öngörüyor, gerekçe artan maliyet ve belirsiz iş değeri, kapsam da tüm yapay zekâ değil yalnızca ajan projeleri.
Bence asıl sorun pilotların ölmesi değil. Pilot ucuz öğrenmedir, bir kısmı ölmeli de. Sorun, ölümlerinin kimse tarafından kayda geçirilmemesi ve yarım kalan her pilotun “devam ediyor” etiketiyle yıllarca küçük bir bütçenin üstünde asılı durması. Bir pilot üç sonuçtan biriyle bitmeli: ölçeklendir, yeniden tasarla ya da sonlandır. Her pilotun da bir bitiş tarihi ve o gün “tamam” ya da “dur” diyecek bir karar sahibi olmalı. Kanıt aşamasını fazla sıkı yönetirseniz öğrenmeyi öldürürsünüz diye bir itiraz gelebilir, ciddiye alıyorum, ama bitiş tarihi sıkılık değil dürüstlük meselesi. Kurumunuz kaç pilot başlattığını biliyordur. Peki kaçını, hangi gerekçeyle kapattığını biliyor mu?
Tasarrufun muhasebesi
Yönetim kurulundaki sessizliğe dönelim, çünkü orada üç ayrı şey “tasarruf” kelimesinin altına sıkışmış durumda.
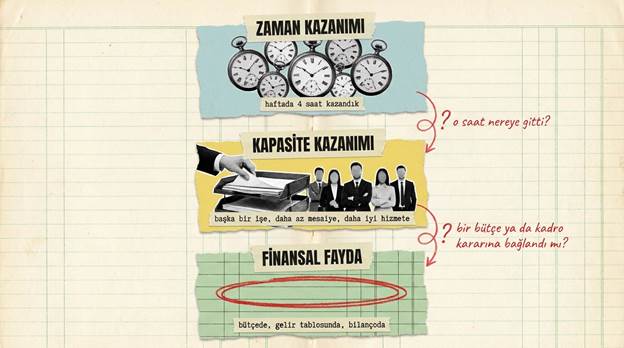
Ok işaretlerinin arasındaki sorular çoğu zaman cevapsız kalıyor. Danimarka’da Anders Humlum ve Emilie Vestergaard, on bir mesleği kapsayan yaklaşık 25 bin çalışan ve 7 bin işyeri için sohbet botlarının etkisine baktı, anket verisini idari kayıtlarla eşleştirdi. Çalışmanın vardığı sonuca göre kazançlarda ya da kayıtlı çalışma saatlerinde anlamlı bir etki yoktu, kullanıcıların kendi bildirdiği ortalama zaman kazancı ise çalışma saatlerinin yüzde 2,8’i kadardı. Yani zaman kazandığını hisseden insan var, o hissin kayıtlara yansıması ise ortada yok.
Birleşik Krallık’ta İş ve Ticaret Bakanlığı da 2024’ün son çeyreğinde 1.000 Copilot lisansı dağıtıp sonucu 2025’te yayımladı. Kullanıcıların yüzde 72’si memnundu, rapor özetleme gibi işlerde hız ve kalite artmıştı, ama değerlendirme zaman kazanımının verimliliği artırdığına dair sağlam kanıt bulamadı. Ayrıntı daha öğretici: sunum hazırlamak ortalama yedi dakikadan fazla hızlanmış, ama çıktılar daha düşük kalitedeydi ve düzeltmelere ihtiyaç olmuş. Excel’de veri analizi ise hem daha yavaş hem daha az doğru çıkmış. Yani aynı araç bir işte kazandırıyor, bir başkasında kaybettiriyor ve “ortalama tasarruf” bu ikisini sessizce birbirine karıştırıyor.
Klarna’nın hikâyesi bu tablonun en gürültülü versiyonu. Şubat 2024’te şirket, yapay zekâ asistanının 700 müşteri temsilcisinin işini yaptığını, sohbetlerin yüzde 75’ini üstlendiğini duyurdu. 2025’te CEO Sebastian Siemiatkowski ise Bloomberg’e, maliyetin fazla baskın bir değerlendirme ölçütü olduğunu ve bunun hizmet kalitesini zedelediğini söyledi, şirket de insan temsilci alımına geri döndü. Bence bu bir yapay zekâ başarısızlığı hikâyesi değil, bir ölçüt başarısızlığı hikâyesi. Sisteme hangi sayıyı verirseniz o sayıyı büyütüyor, geri kalanını kimse sormuyor.
Peki ya doğru ölçenler? Singapur’daki DBS Bank, 2025’te yapay zekâ girişimlerinden yaklaşık 1 milyar Singapur doları ekonomik değer elde ettiğini açıkladı, 2024’te bu rakam 750 milyondu. Yıllık rapor sayfası yöntemi söylemiyor ama Business Times’a anlatılana göre rakam, yapay zekâ çözümü sunulan müşterilerle sunulmayan bir kontrol grubunu karşılaştırarak hesaplanmış. Aynı haberde CEO Tan Su Shan, yapay zekâ günlük iş akışlarına gömüldükçe değerini ayırmanın zorlaşacağını, bundan sonra değerin daha çok kapasite inşasından geleceğini söylüyor. Yani ölçmeyi en iyi bilen kurum bile ölçümün bir yerde kırıldığını kabul ediyor.
Karşı tarafın en güçlü sesi ise JPMorgan’dan geliyor. CEO Jamie Dimon, Ekim 2025’te yapay zekâ yatırımının kendini amorti ettiğini söylemişti. Ekim 2026’daki üçüncü çeyrek çağrısında CFO Jeremy Barnum’un, The Stack’in aktardığına göre, yapay zekâ getirilerini rakamlaştırmaktan uzaklaşmak istediğini, çünkü bunun kurum içinde insanların zamanını yediğini ve büyük bir bankada sonuçların zaten geç göründüğünü söylediği aktarılıyor. Barnum aynı çağrıda Dimon’ın 2 milyar dolarlık harcama rakamının tam doğru olmadığını, gerçek harcamanın yılda yaklaşık 700 milyon dolar olduğunu da eklemiş. Bunu birden fazla kaynaktan doğrulayamadım o yüzden kesin olgu gibi değil, doğrulanması gereken güçlü bir işaret gibi düşünün. Doğruysa bile içinde haklı bir yan var: ölçmenin de bir bedeli var.
İşte bu yüzden çözümün her şeyi sürekli ölçmek olduğunu düşünmüyorum. Tasarruf, ölçülmeden önce tanımlanması gereken bir şey. Bir süreçte yapay zekâ sayesinde ayda 100 saatlik iş yükü ortadan kalktıysa, o saatlerin kimin zamanından kazanıldığını, başka bir işte kullanılıp kullanılmadığını, fazla mesainin ya da dış kaynak ihtiyacının azalıp azalmadığını, aynı kaynakla daha çok iş yapılıp yapılmadığını ve hizmet kalitesinin ölçülebilir biçimde iyileşip iyileşmediğini sormak zorundasınız. Bu soruların cevabı yoksa o 100 saat henüz bir iş değeri değil. Burada başlangıç ölçümü, yani “baseline” devreye giriyor. İşlem süresi, hata oranı, çalışan başına hacim, maliyet, müşteri memnuniyeti. Başlangıç ölçümü olmayan bir inisiyatif onaylı portföye girmemeli. Barnum’un kaygısını da boşa saymıyorum, o yüzden karar kapısında bir “baseline” ve tek bir fayda göstergesi isteyin, üretime çıktıktan sonra da çeyrekte bir hafif bir doğrulama yapın, gerisini bırakın.
Her şey stratejikse
Holdinglerde her proje “stratejik” olur, bilirsiniz. Genel müdürlüğün projesi stratejiktir, iş biriminin projesi stratejiktir, tedarikçinin getirdiği demo da bir şekilde stratejik hâle gelir. Hepsi Önemli. Hepsi öncelikliyse hiçbiri öncelikli değildir, ve önceliklendirmenin tek gerçek kanıtı reddedilenlerin listesidir.
Kısa bir filtre kullanıyorum, beş soruluk. Hangi iş problemini çözüyor ve değeri ne? Veri ve teknoloji hazır mı? Sonuçtan kim sorumlu? Başka süreçlere ya da şirketlere yayılabilir mi? Beşinci soru da bence en ihmal edileni. Yapay zekâ gerçekten gerekli mi? Her dijital dönüşüm problemi yapay zekâ gerektirmez, bazısı süreç sadeleştirmeyle, bazısı klasik otomasyonla, bazısı da veri altyapısını düzeltmekle çözülür. Gartner’dan Anushree Verma ajan projeleri için bunu açık söylüyor: bugünkü projelerin çoğu hevesin sürüklediği, çoğu zaman yanlış uygulanan erken deneyler ve satıcılar da sohbet botlarını ya da asistanları “ajan” diye yeniden etiketliyor, Gartner buna “agent washing” diyor. Etiket değişince problem değişmiyor ki.
Bir yapay zekâ yöneticisinin başarısı, hayata geçirdiği proje sayısıyla ölçülmemeli bence, ya da yalnızca onunla ölçülmemeli. Kurumu yapmaması gereken projelerden ne kadar koruduğu da bir ölçüt, ve bunu ölçen kimse yok.
Merkez mi, şirketler mi?
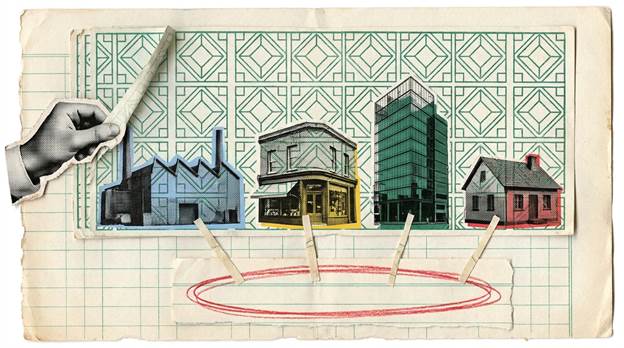
Birden çok şirketi olan bir yapıda ikinci büyük soru şu: dönüşümün merkezi neyi yönetmeli, neyi iş birimlerine bırakmalı, yahu nerede duracak bu merkez? Bence paylaşılan şey platform değil, desen olmalı. Bir şirkette işe yarayan doküman işleme çözümü ikinci şirkete aktarılabilir, ama ikincinin süreçleri, veri yapısı, yetkileri ve iş kuralları aynı değil. Merkez her yere aynı uygulamayı dayatırsa yavaşlatır, hiçbir şeyi ortaklaştırmazsa da aynı pilot beş şirkette beş kez yapılır. Ortaklaştırılacak olanlar bellidir: mimari ve güvenlik standartları, veri tanımları, izin mekanizmaları, başarı ölçütleri, yeniden kullanılabilir bileşenler ve fayda raporlama biçimi. Süreçlerin sahibi ise iş birimi olarak kalır.
Bunu yazıya dökmenin en kolay yolu, kimin neye “dur” diyebildiğini bir tabloya koymak. Aşağıdaki dağılım örnek, kendi yapınıza göre değişir.
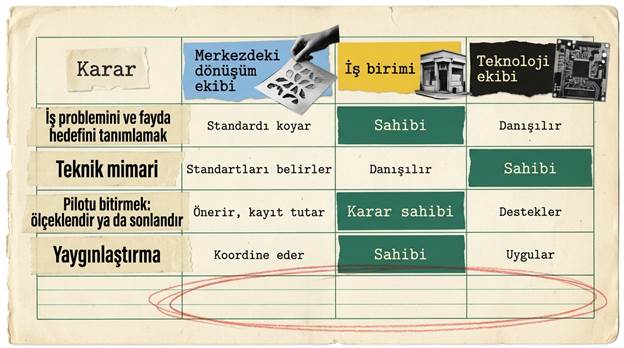
Yetki olmadan koordinasyon olmaz, hesap verebilirlik olmadan da sahiplik. Merkezdeki ekibin kimsenin patronu olması gerekmiyor. Ama kararların nerede alındığını, kaynakların nasıl dağıtıldığını ve sonuçlardan kimin sorumlu olduğunu yazılı hâle getiren bir yönetişim yoksa rol zamanla, farklı departmanların proje durumlarını toplayıp üst yönetime sunan bir raporlama koordinatörlüğüne dönüşür.
Bu bölümün sessiz tehlikesi tedarikçi bağımlılığı. Her şirket kendi platformunu, kendi lisansını, kendi danışmanını seçtiğinde aynı iş için birden fazla lisans alınıyor, veri farklı yerlere dağılıyor. Çözümler birbiriyle konuşamıyor ve toplam sahip olma maliyeti hiçbir tabloda toplanmıyor. Teknoloji seçerken yalnızca lisans bedeline bakmak yetmez, entegrasyon, bakım, güvenlik, model kullanım maliyeti, verinin taşınabilirliği ve çıkış maliyeti de mutlaka hesaba girmeli. Bu soruyu daha önce Modelin Dışındaki Her Şey yazısında ajanlar için sormuştum. Yarın modeli ya da sağlayıcıyı değiştirsem, talimatlarımdan, araçlarımdan ve hafızamdan hangisi benimle gelir? Kurumsal ölçekte de aynı soru geçerli.
Kullanım değil, iş yapış biçimi
Birçok kurum benimsemeyi lisans sayısı, aktif kullanıcı oranı ya da yazılan komut sayısıyla ölçüyor. Bunlar kullanım göstergesi, dönüşüm göstergesi değil. Bir çalışan her gün yapay zekâ kullanıyor olabilir ama çıktıyı kopyalayıp eski sürecin içine yapıştırıyordur, daha az kişiyle çalışan bir otomasyon ise bir iş akışını baştan sona değiştirebilir.
BBVA’nın OpenAI ile yürüttüğü yaygınlaştırma bu ikisini aynı vitrinde gösteriyor. OpenAI’nin yayımladığı vaka çalışmasına göre çalışanlar haftada yaklaşık 3 saat kazanıyor, kullanıcıların yüzde 83’ü haftalık aktif, iş akışı testlerinde verimlilik artışı yüzde 80’in üzerinde. Peru’da kurum içinde geliştirilen bir asistan da sorgu işleme süresini yaklaşık 7,5 dakikadan yaklaşık 1 dakikaya indirmiş. Tabii bunlar tedarikçinin kendi anlatımı ve zaman kazanımı çalışanların beyanına dayanıyor, yani Danimarka ve Birleşik Krallık örneklerindeki soru burada da geçerli. Ama bence ilginç olan, en güçlü sonucun “herkes kullanıyor” satırından değil, tek bir sürecin sonuna kadar yeniden kurulduğu satırdan gelmesi.
McKinsey’nin verisi de aynı yöne bakıyor. Yaklaşık 2.000 katılımcılı araştırmada kurumların ancak üçte biri yapay zekâyı ölçeklemeye başladığını söylüyor, yüksek performanslı kurumlar (yaklaşık yüzde 6) iş akışlarını kökten yeniden tasarlama olasılığında yaklaşık üç kat önde, test edilen özellikler arasında da iş akışı yeniden tasarımı kâr etkisiyle en güçlü ilişkiyi gösteriyor. Dürüst olalım, bu bir korelasyon, nedensellik kanıtı değil. Yine de bence yön belli. Bir kurumda yapay zekâ dönüşümü, çalışanların yeni bir araç kullanmaya başlamasıyla gerçekleşmiyor, eski iş yapma biçimine artık ihtiyaç duymadıklarında gerçekleşiyor.
Korkuluklar
Kanada’da Jake Moffatt, Air Canada’nın sitesindeki sohbet botundan yas indirimi hakkında bilgi aldı, bot yanlış bilgi verdi. Moffatt da buna göre bilet aldı. Havayolu savunmasında botun kendi eylemlerinden sorumlu ayrı bir tüzel kişi gibi düşünülebileceğini öne sürdü. Mahkeme üyesi Christopher Rivers bu savı dikkat çekici buldu ve reddetti. Bot sitenin bir parçası, bilgi durağan sayfada da çıksa botta da çıksa şirket sorumlu. Şubat 2024’te verilen karar (Moffatt v. Air Canada, 2024 BCCRT 149) şirketi faiz ve harçlarla birlikte toplam 812,02 Kanada doları ödemeye mahkûm etti. Tutar küçük, ilke büyük: sorumluluk botta değil, botu yayına alanda kalıyor.
Sorumlu yapay zekâyı yalnızca KVKK ve bilgi güvenliği başlıklarına sıkıştırmak ise yetmiyor. Bir kurumsal yapay zekâ yönetişimi en az beş soruya cevap vermek zorunda. Hangi veriye kim erişebilir, yapay zekâ hangi kararları alabilir ve hangilerini alamaz, çıktının doğruluğunu kim kontrol eder, yapılan işlemler geriye dönük izlenebiliyor mu, bir hata olduğunda müdahale ve sorumluluk kimde? Ajan tabanlı sistemlerde bu sorular daha da kritik, çünkü artık yalnızca içerik üreten değil, sistemler üzerinde işlem yapan yapılardan söz ediyoruz. Modelin Dışındaki Her Şey yazısında Anthropic’in kendi ölçümüne göre kullanıcıların izin istemlerinin yaklaşık yüzde 93’ünü kabul ettiğini yazmıştım. Düşünsenize, kapıda bir bekçi var ama gelenlerin yüzde 93’üne “geç” diyor. “Kritik işlerde insan onayı” cümlesi bu rakamdan sonra yeniden düşünülmeli, çünkü onay penceresi güvenlik katmanından çok bir alışkanlığa dönüşebiliyor.
Teknik güvenlikle kurumsal hesap verebilirlik de aynı şey değil. Bir sistem güvenli çalışıp yanlış göstergeyi optimize ediyor olabilir, doğru sonuç üretip kararın sorumlusu belirsiz kalabilir. Jüride Algoritma Var yazısında ölçütü kimin koyduğu sorusunun etrafında dolanmıştım. Burada da aynı soru geçerli. Projenin başarısını ölçen göstergeyi kim koyuyor, iş birimi mi, teknoloji tedarikçisi mi, dönüşüm ekibi mi? Klarna’daki “maliyet fazla baskın ölçüt oldu” cümlesi tam olarak bu sorunun cevapsız kalmasının bedeli. Korkuluk bu yüzden bence fren değil, ölçeklenebilmenin ön koşulu.
Pazartesi sabahı
Peki bütün bunlar Pazartesi sabahı neye dönüşüyor? Aşamalı bir plan önerim var. Aşamalar ve bitiş ölçütleri kaynaklardaki pratiklerden türettiğim bir derleme, kimsenin resmî tarifi değil. İçindeki sayılar da örnek, kendi kurumunuzda ölçerek ayarlayın.
İlk 30 gün görünürlük kazanma zamanı. Mevcut yapay zekâ ve dijital dönüşüm inisiyatiflerinin envanterini çıkarın, her biri için iş sahibini ve başlangıç ölçümünü yazın, devam eden pilotları ölçeklendir, yeniden tasarla ya da sonlandır diye üç kutuya ayırın. Bitiş ölçütü: sahibi, hedefi ve ölçüm yöntemi belli olmayan hiçbir inisiyatif onaylı portföyde yok.
İlk 90 günde önceliklendirmeyi kurun. Beş soruluk filtreyi ortak bir değerlendirme modeline çevirin, finans ve iş birimleriyle fayda hesaplama standardını birlikte yazın. Burada “üç proje canlıda” demiyorum, çünkü altyapı, veri kalitesi ve entegrasyon karmaşıklığı bunu çoğu yerde gerçekçi kılmıyor. Bitiş ölçütü: her öncelikli proje ya canlıda ya da finansın onayladığı bir fayda hedefiyle doğrulanmış pilot aşamasında, sorumlu iş sahibi ve karar mekanizması da belli.
İlk altı ayda ölçekleme denenir. İlk uygulamaların fayda gerçekleşmesi ölçülür, başarılı bir çözüm ikinci bir iş biriminde denenir, yönetişim ve kullanıcı adaptasyonu mekanizmaları oturtulur. Bitiş ölçütü: en az bir çözüm ikinci bir iş biriminde ya da şirkette sıfırdan geliştirilmeden, uyarlanarak değer üretiyor. Altı ayın başarısını kaç projenin bittiğiyle değil, kurumun bundan sonra projeleri nasıl seçip yöneteceğiyle ölçmek gerekiyor.
Salona dönelim
O yönetim kurulu salonundaki sessizlik vardı ya… Aslında CFO’nun sorusu kötü bir soru değil, belki de salondaki en iyi soru. “Hangi kalemde görünecek?” sorusunun cevabı bazen gerçekten bir kalem olur, bazen “bir kısmı kapasite, o da henüz kimseye atanmadı” olur, bazen de “bilmiyoruz ama bir sonraki toplantıya kadar öğreneceğiz” olur. Üçü de kabul edilebilir cevap. Kabul edilemeyen, sorunun hiç sorulmaması.
Teknoloji bir kapasite yaratıyor, o kapasiteyi değere çevirmek ise bir yönetim meselesi. Şirketinizdeki son yapay zekâ pilotunun yarattığı tasarruf bugün kimin bütçesinde görünüyor?
Kaynak notları
Resmî ve birincil kayıt. Birleşik Krallık İş ve Ticaret Bakanlığı’nın Copilot değerlendirmesi, Gartner’ın 2024 basın açıklaması, DBS’in 2025 yıllık raporu (rakamı veriyor, yöntemi söylemiyor).
Ön baskı ve araştırma. Humlum ve Vestergaard, NBER Working Paper 33777 (BFI sürümü). McKinsey’nin State of AI 2025 araştırması anket temelli, iş akışı yeniden tasarımı bulgusu korelasyonel.
Şirketin kendi beyanı. OpenAI’nin BBVA vaka çalışması: rakamlar tedarikçinin yayını ve zaman kazanımı çalışanların beyanına dayanıyor, bağımsız doğrulama görmedim. Dimon’ın harcama ve getiri iddiası için Entrepreneur haberi.
Basın ve yorum. MIT/NANDA raporunun Virtualization Review özeti ve rakamın yöntemine yönelik BigDATAwire eleştirisi, S&P Global anketinin CIO Dive aktarımı, Gartner ajan tahmininin Reuters kaynaklı The Star ve Outlook Business kopyaları, Birleşik Krallık denemesine dair The Register, DBS’in kontrol grubu yöntemi ve Tan Su Shan’ın sözleri için Business Times’tan FCC Singapore aktarımı, Klarna için eMarketer ve Entrepreneur, Air Canada kararı için MobileSyrup ve Law360 Canada.
Tek kaynaklı iddia. Barnum’un sözleri ve 700 milyon dolarlık düzeltme yalnızca The Stack haberinde var.
Kendi yazılarım. Modelin Dışındaki Her Şey ve Jüride Algoritma Var.