

Yazının birinci bölümünü buradan okuyabilirsiniz.
OpenAI’ın Eylül 2026’daki Navier–Stokes duyurusundan on iki saat önce, aynı yolu aylardır yürüyen iki matematikçi kendi sonuçlarını açıklamıştı; biri o süreçte OpenAI’ın kodlama aracını kullanıyordu. Birinci bölüm olayın matematiğini anlattı. Bu bölüm asıl soruyu matematiğin dışına taşıyor: düşünme sürecini bir platforma emanet eden her profesyonel için, ajanslar, stüdyolar, yazarlar ve yapımcılar için, “veri” artık ne demek?
İstanbul’da orta ölçekli bir ajans, bir perakende markası için rekabetçi bir konkura hazırlanıyor. Kreatif ekip üç haftadır bir kampanya platformu üzerinde çalışıyor: bir içgörü, bir ana fikir, bir slogan ailesi, üç filmlik bir yapı. Ekip taslakları, senaryoyu, alternatif sloganları ve sunumu her gün yapay zekâ asistanına giriyor: “bunu kısalt”, “bu içgörüye üç farklı açı yaz”, “bu senaryoyu 30 saniyeye indir”. Hesap, art direktörün kendi kartıyla açtığı normal hesap. Ekipten kimse kullanım şartlarını okumadı; okusa da ne değişecekti ki zaten?
Bu sahnede sızan şey ne? Markanın adı değil; platformun kimlik arındırma filtresi onu muhtemelen siler. Sızan şey, bir kampanya platformunun oluşum süreci: hangi içgörüden hangi fikre nasıl gidildiği, hangi alternatiflerin neden elendiği, hangi sloganın neden kazandığı. Bu, ajansın gerçek ürünü. Reklam filmi bir çıktı; o çıktıya götüren yargı dizisi, ajansın onlarca yılda biriktirdiği şey.
Bu sahne kurgu. Eylül 2026’da matematikte gerçekleşen hâli şöyle.
7 Eylül gece yarısına dakikalar kala New York Üniversitesi’nden Tristan Buckmaster, Anthropic’te çalışan ortak yazarı Levent Alpöge ile birlikte, üç boyutlu kuvvetli Euler denklemlerinde sonlu zamanda “patlama” gösteren, Lean kanıt asistanında biçimsel olarak doğrulanmış bir sonucu duyurdu. Terence Tao aynı gün bu sonucu “bir kırılma” olarak niteledi ve aynı yöntemlerin Navier–Stokes’a uzanma olasılığının yüksek olduğunu yazdı (Terence Tao). On iki saat sonra OpenAI, yaklaşık 10.000 eşzamanlı ajanın 88 saatte ürettiği 166 sayfalık bir kanıtla Navier–Stokes’un Clay ödül şartlarından birini (pürüzsüz dış kuvvet altında patlama, C/D ifadeleri) karşıladığını açıkladı; dış kuvvetsiz “saf” problem hâlâ açık (OpenAI). Buckmaster’ın Lean doğrulamalı Euler kanıtı 22 Ağustos’tan beri elindeydi ve aylar süren çalışması boyunca OpenAI’ın Codex aracını kullanmıştı. Ayrıntılar, kanıtın matematiği ve Fields madalyalılarının bildirisi bu yazının birinci bölümünde; burada olayın diğer yüzü var.
Bu bölümün tezi şu: düşünme sürecini kiraladığın platformun, o süreci senden daha hızlı ve daha büyük ölçekte kullanabildiği bir dünyada prompt artık bir girdi değil, bir ürün.
1. “Sherlocking”: bir Mac uygulamasından bir dijital ekonomi kalıbına
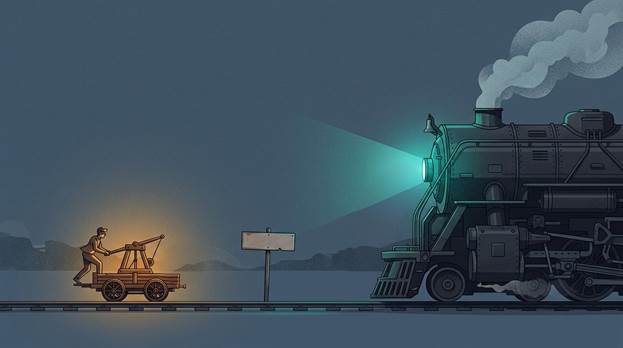
Kasım 2001’de Dan Wood’un küçük şirketi Karelia Software, Watson adında bir Mac uygulaması çıkardı. Watson, o günlerde yeni yeni ortaya çıkan web servislerini (hava durumu, film seansları, telefon rehberi, e-ticaret araması) tek bir pencerede toplayan, 29–30 dolara satılan bir araçtı ve bir Apple Design Award kazandı. 18 Eylül 2002’de Apple, Mac OS X 10.2 Jaguar ile birlikte Sherlock 3‘ü yayımladı (zaman içinde de Spotlight’a dönüştü): aynı işi yapan, işletim sisteminin içine gömülü ve ücretsiz bir uygulama. Watson bir yıl içinde piyasadan silindi. Anlatıya göre Steve Jobs, Wood’a telefon açıp durumu bir benzetmeyle özetledi: Karelia el arabasıyla rayların üstünde gidiyordu; Apple rayların sahibi olan lokomotifti (512 Pixels; How-To Geek).
“Sherlocked” lafı böyle doğdu ve o günden beri her WWDC’de yeniden listelendi: Konfabulator’ın Dashboard’a, Growl’un bildirim merkezine, f.lux’un Night Shift’e, Duet Display’in Sidecar’a, 1Password’ün sistem şifre yöneticisine dönüşmesi (AppleInsider). Kalıp hep aynı: bağımsız bir geliştirici bir ihtiyacı keşfeder, çözümü platformun üzerinde inşa eder; platform ihtiyacın gerçek olduğunu o çözümün başarısından öğrenir ve onu kendisinin yapar.
Bu kalıbın daha sert bir versiyonu Amazon’da görüldü. Wall Street Journal’ın 23 Nisan 2020 tarihli soruşturması, Amazon’un özel markalı ürün ekibindeki yirmiden fazla eski çalışan ve şirket içi belgelere dayanarak, üçüncü taraf satıcılara ait satış verilerinin Amazon’un kendi ürünlerini geliştirmekte kullanıldığını yazdı; örnek olarak Fortem markalı bir araç bagaj düzenleyicisinin verilerine erişildiği anlatılıyordu (Fox Business/WSJ aktarımı). 29 Temmuz 2020’de Temsilciler Meclisi Yargı Komitesi önünde Jeff Bezos’a bu soruldu. Cevabı, olayı tanımlayan cümle oldu: “we have a policy against using seller-specific data … But I can’t guarantee you that that policy has never been violated” (VentureBeat). Politika vardı; politikanın uygulandığını dışarıdan doğrulamanın yolu yoktu. Ardından SEC incelemesi ve Eylül 2023’te FTC’nin antitrust davası geldi.
Google’ın 2011–2012’de Yelp ve TripAdvisor gibi dikey sitelerin içeriğini kendi ürünlerine taşıması üzerine FTC soruşturması, Facebook’un satın aldığı Onavo VPN üzerinden rakip uygulamaların kullanımını izleyip stratejik kararlar alması aynı ailenin üyeleri. Ortak nokta şu: platformun kendi kullanıcılarının davranışından ürettiği bilgi, o kullanıcılarla rekabet etmek için kullanılıyor.
Yapay zekâ çağında bu kalıbın kendi versiyonu da oluştu. 2023’ten bu yana OpenAI’ın API’si üzerine kurulu “sarmalayıcı” (wrapper) startup’ların, her DevDay’de birinci parti bir özellikle (GPT’ler, Deep Research, Operator) değersizleştiği tartışması, “AI sherlocking” ifadesini yaygınlaştırdı. Ama Navier–Stokes olayı bu kalıba yeni bir katman ekliyor. Watson’ın kodu Apple’ın elinde değildi; Apple ihtiyacı gördü, kendi çözümünü yazdı. Amazon’da satıcının satış verisi Amazon’un sunucusundaydı; Amazon o veriyi görüyordu. Codex’te ise araştırmacının düşünme süreci, hipotezleri, deneme yanılmaları, yarım kalmış ispat adımları platformun sunucusundan geçiyor. Sherlocking’in Watson versiyonu “senin ne yaptığını görüyorum” idi. Amazon versiyonu “senin ne sattığını görüyorum“. Yapay zekâ versiyonu “senin nasıl düşündüğünü görüyorum“. Üçüncüsü, ilk ikisinden niteliksel olarak farklıdır.
2. Prompt bir üründür: veri sorusunun anatomisi
Buckmaster’ın iddiasının çekirdeği, teknik olarak iki cümleyle özetlenebilir. Birincisi: Aylardır Codex oturumlarına girdiğim hipotezler ve ispat adımları, OpenAI’ın iç sistemine bir şekilde ulaşmış olabilir. İkincisi: Bunun olup olmadığını ben bilemem; ancak OpenAI bilebilir.
OpenAI’ın yanıtı iki aşamalı oldu. 8 Eylül’deki orijinal metinde, araştırmacıların ve ajanların Buckmaster–Alpöge’nin çalışmasını kamuya açıklanmadan önce hiçbir yolla görmediği ve “bu problemi çözmek için hiçbir spesifik kullanıcı verisine erişilmediği” yazıyordu. 10 Eylül’deki güncellemede ise ifade kesinleşti: Bir soruşturmanın ardından, Buckmaster’ın son iki aydaki Codex prompt’larının sistemi “eğitim dâhil hiçbir şekilde etkileyemediği” doğrulanmıştı (OpenAI, dipnot 2).
Bu ifadenin doğru olmadığını gösteren hiçbir kanıt yok. Ama yazıdaki iddia tam da burada başlıyor: ifadenin doğru olduğunu gösteren, şirketin kendi soruşturması dışında bir kanıt da yok. Bezos’un 2020’deki cümlesiyle OpenAI’ın 2026’daki cümlesi arasındaki fark, ikincisinin kesin olması; benzerlik ise ikisinin de yalnızca şirketin kendi iç görüşüne dayanması. Amazon’daki satıcı, Amazon’un politikasına uyup uymadığını denetleyemiyordu. Codex kullanan araştırmacı da OpenAI’ın soruşturmasını denetleyemiyor. Jordan Ellenberg’in Quomodocumque blogundaki tespiti bunu iyi özetliyor: OpenAI olayının kalbinde teknik sonuçtan çok, tarafların göreli konumlanmasına dair bir halkla ilişkiler kampanyası var. Axios’un 8 Eylül’deki çerçevesi ise soruyu doğrudan koyuyor: Bu tartışma, yapay zekâ destekli bilim için temel bir güven sorusuna dokunuyor; araştırmacılar, sınır laboratuvarlarının araçlarını yayımlanmamış keşifler üzerinde güvenle kullanabilir mi (Axios)?
Sorunun cevabı, Buckmaster olayından bağımsız olarak, Eylül ayının ortasında biraz daha netleşti.
Project Lily: “otonom” sistemin arkasındaki insanlar
14 Eylül 2026’da 404 Media, OpenAI’ın “Project Lily” adlı programının haberini yaptı (404 Media). Habere göre OpenAI, yüzlerce dış yükleniciye gerçek ChatGPT konuşmalarını okutup modelin dört aday yanıtını 1’den 7’ye puanlatıyor. Yükleniciler tek bir mesajı değil, konuşmanın tamamını görebiliyor. İşe alım Crossing Hurdles üzerinden, ödeme Mercor üzerinden yapılıyor; bir işçi saatte 50 doların üzerinde aldığını söylüyor. Bazı sohbetlerde hassas kişisel veri var.
Bu haberin veri sorusu açısından üç kritik ayrıntısı var.
Birincisi, yüklenicilerin gördüğü ekranda bir “kullanıcı hafızası özeti” bulunuyor: kullanıcının geçmiş kullanımını özetleyen, bazen yaklaşık konumunu da içeren bir metin. Yani insan incelemeci, tek bir oturumu değil, o kullanıcının platformla ilişkisinin damıtılmış bir hâlini görüyor (Tom’s Hardware).
İkincisi, ayarların çalışma biçimi. 404 Media ve IBTimes’ın aktardığına göre, ChatGPT’de “modeli herkes için iyileştir” seçeneğini kapatmak. Daha önce veri havuzuna aktarılmış sohbetleri geriye dönük olarak silmiyor. Silinen sohbetler yaklaşık 30 gün içinde kaldırılsa da, kimliği arındırılmış içerik bu sürenin ötesinde de saklanabiliyor. Kısacası kapatma düğmesi geçmişi temizlemiyor; yalnızca ileriye dönük çalışıyor.
Üçüncüsü, “Privacy Filter”. OpenAI, 404 Media’ya konuşmaların insan incelemecilere ulaşmadan önce isim, adres, e-posta ve telefon gibi tanımlayıcıları ayıklayan bir model varyantından geçtiğini söyledi. Aynı açıklamada, filtrenin özellikle kısa konuşmalarda “bağlam içinde kişisel önem taşıyan” ya da alışılmadık tanımlayıcı içerikleri kaçırabildiğini de kabul etti.
Bu üçüncü nokta, Buckmaster olayını Project Lily’ye bağlayan halka. Bir Privacy Filter ismi siler. Bir ispat stratejisini silmez. Bir matematikçinin Codex’e girdiği “şu lemmayı şu yüksek frekanslı düzeltmeyle dene” cümlesinde kişisel tanımlayıcı yoktur; ama o cümle, alanın en değerli bilgisidir. Nicholas Carlini ve ekibinin 2021’den bu yana yayımladığı ezberleme ve eğitim verisi çıkarma çalışmaları, büyük dil modellerinin eğitim verisini bazen kelimesi kelimesine geri verebildiğini gösteriyor; üyelik çıkarımı literatürü de bir örneğin eğitim kümesinde olup olmadığının dışarıdan tahmin edilebildiğini. Kimlikten arındırma, bir metnin kimin olduğunu gizler; ne olduğunu değil. Sherlocking’in yapay zekâ versiyonunda çalınan şey isim değil, yöntemdir.
Bir de karşılaştırma var. 404 Media’ya göre Anthropic de insan incelemesi yaptığını doğruladı; ancak yalnızca “modellerimizi iyileştirmeye yardım et” seçeneğine opt-in olan kullanıcılar için. Anthropic’in 28 Ağustos 2025’te duyurduğu tüketici şartları değişikliğinde ise madalyonun öteki yüzü var: model eğitimine izin veren kullanıcılar için veri saklama süresi 30 günden beş yıla çıktı; silinen konuşmalar gelecekteki eğitimde kullanılmıyor (Anthropic). Yani opt-in ile opt-out arasındaki fark yapısal; ama her iki tarafta da tüketici hesabı, iş hesabından farklı bir sözleşmeyle çalışıyor. OpenAI’ın kurumsal gizlilik sayfası, Team, Enterprise ve API katmanlarında verinin varsayılan olarak eğitimde kullanılmadığını söylüyor (OpenAI, Enterprise privacy). Buckmaster’ın hangi katmanı kullandığı kamuya açık değil; ama Project Lily’nin anlattığı mekanizmaların tamamı tüketici katmanı içindir ve dünyanın en iyi matematikçilerinden biri de dâhil olmak üzere, çoğu profesyonel bu araçlara tüketici hesabıyla başlar.
Çark neden durmaz
Bu noktada olayı kişilerden çıkarıp mekanizmaya bakmak gerekiyor; çünkü Bubeck’in ne söylediğinden bağımsız olarak, mekanizma aynı sonucu üretir.
Bir yapay zekâ platformunun ekonomisi bir çark üzerine kurulu. Daha çok kullanıcı, daha çok etkileşim verisi üretir; etkileşim verisi, ister eğitimde ister insan değerlendirmesinde ister ürün kararlarında kullanılsın, modeli ve ürünü iyileştirir; daha iyi ürün, daha çok kullanıcı getirir. Amazon’un çarkı satıcı verisiyle, Google’ınki arama davranışıyla dönüyordu. Yapay zekâ platformunun çarkı, kullanıcının düşünme süreciyle dönüyor. Bu çarkın en değerli girdisi, sıradan kullanıcının sohbeti değil; alanının en iyisi olan kullanıcının, yayımlanmamış işini platformun içinde geliştirirken bıraktığı iz.
Çarkın bu özelliği bir tasarım hatası değil; iş modelinin kendisi. Ve tam da bu yüzden, “kullanmadık” cümlesinin dışarıdan doğrulanamaması yapısal bir sorun. Şirketin dürüst olup olmadığı sorusu değil bu; şirketin dürüstlüğünün, sistemin güvenilirliği için yeterli olup olmadığı sorusu. Finans sektöründe “biz kendi kendimizi denetledik, sorun yok” cümlesi bir denetim raporu sayılmaz; bağımsız denetçi, iç kontrol, kayıt zorunluluğu vardır. Yapay zekâ platformlarının yayımlanmamış fikirlerle ilişkisinde bu kurumların hiçbiri henüz yok. Cannes Lions’ın kaynak materyal ve doğruluk beyanı şartı, WGA’nın ifşa maddesi, Clay’in iki yıllık bekleme kuralı; bunların hepsi, bir sonucun nasıl üretildiğini sonucu üretenden bağımsız bir tarafın görebilmesi için kurulmuş mekanizmalar. Platform tarafında bunun karşılığı, henüz “bize güvenin”den ibaret.
Bu çarkı durdurmanın yolu platformları kullanmamak değil; Buckmaster’ın kendisi de aylarca Codex kullandı ve bundan pişman olduğunu söylemedi. Yol, çarka giren malzemenin kaderinin sözleşmeyle, kayıtla ve gerektiğinde bağımsız denetimle belirlenmesi. Yaratıcı sektörün son üç yılı, tam olarak bu kurumları inşa etmekle geçti.
Sahneye dönmek
Yazının başındaki ajansa dönelim. Navier–Stokes’un yapısını bu sahneye uygula. Rakip ajans aynı platformun tüketici hesabını kullanıyor; platform bir gün “kampanya platformu geliştirme” özelliği çıkarıyor; ya da sadece, aynı marka için aynı hafta aynı araca aynı soruları soran iki ajansın prompt’ları, aynı insan incelemecinin ekranından geçiyor. Bunlardan hiçbirinin olduğuna dair kanıt yok. Olmadığına dair kanıt da yok. Buckmaster’ın durumu tam olarak bu ve reklamcılığın Buckmaster’ı olmamanın tek yolu, aracı kullanmamak değil; aracın hangi katmanını hangi malzemeyle kullandığını bilerek karar vermek.
Bu sahnenin bir de sessiz kahramanı var: 22 Ağustos. Buckmaster’ın elinde tarihli, üçüncü taraf bir sistemle doğrulanmış bir kanıt vardı; öncelik tartışması bu yüzden onun lehine yürüyebildi. Ajansın elinde ne var? Kreatif brief’in, tretmanın ve ana fikrin tarihli bir kaydı yoksa, tartışmanın kendisi bile mümkün değil. Bu yüzden zaman damgası, pratik önerileri arasında en sıradan görünen ama en belirleyicisi.
3. Yaratıcı sektör bu filmi daha önce gördü
Matematikçiler için Eylül 2026’da patlayan sorunun, yaratıcı sektör için 2023’ten beri farklı sahnelerde tekrarlanan bir versiyonu var. Örüntü her seferinde aynı: bir araç, kullanıcının içeriğini ya da davranışını modeli geliştirmek için kullanma hakkını sözleşmeye yazar; kullanıcılar bunu fark eder; şirket geri adım atar ya da atmaz.
Zoom, Ağustos 2023. Mart ayında güncellenen kullanım şartlarındaki bir madde, müşteri içeriğinin yapay zekâ eğitiminde kullanılmasına izin veriyordu. Madde 6 Ağustos’ta viral olduğunda CEO Eric Yuan üç gün içinde LinkedIn’de müşteri içeriğiyle açık rıza olmadan asla model eğitmeyeceklerini yazdı ve olayı “içeride bir süreç hatası” olarak tanımladı (Axios).
Slack, Mayıs 2024. TechCrunch’ın 17 Mayıs’ta yazdığına göre Slack, müşteri mesajlarını ve kullanım verisini varsayılan olarak makine öğrenmesi modellerinde kullanıyor; vazgeçmek için çalışma alanı yöneticisinin e-posta göndermesi gerekiyordu. Slack, üretken Slack AI’ın müşteri verisiyle eğitilmediğini açıkladı; eleştirilen şey eğitimin kendisi değil, varsayılanın “açık” olmasıydı (SecurityWeek).
Adobe, Haziran 2024. Yeni kullanım şartlarındaki “içeriğinize otomatik ve manuel yöntemlerle erişebiliriz” dili, fotoğrafçılar ve tasarımcılar arasında isyana yol açtı. Adobe 6 ve 10 Haziran’da açıklama yaptı, 24 Haziran’da şartları yeniden yazdı: yerel ya da bulut içeriği üretken yapay zekâ eğitiminde kullanılmayacak, Adobe Stock katkıları istisna (No Film School). Yaratıcı sektörün en büyük yazılım tedarikçisi, üç haftada sözleşmesini müşterilerinin şüphesine göre yeniden yazmak zorunda kaldı.
Figma, Temmuz 2024. Config’de tanıtılan “Make Designs” özelliği, bir tasarımcının “hava durumu uygulaması” istemine Apple’ın Weather uygulamasına neredeyse birebir benzeyen çıktılar verince 2 Temmuz’da durduruldu. CEO Dylan Field, modellerin Figma kullanıcı içeriğiyle eğitilmediğini, sorunun tasarım sistemindeki çeşitlilik eksikliğinden kaynaklandığını söyledi (9to5Mac). Burada ironi katmanlı: Figma kullanıcıları, kendi tasarımlarının eğitim verisi olmasından korkarken; aracın çıktısı başka bir şirketin tasarımını kopyalıyordu.
Getty v. Stability AI. Londra Yüksek Mahkemesi 4 Kasım 2025’te Getty’nin ikincil telif iddiasını reddetti: model ağırlıkları “ihlal eden kopya” değil, eğitim Birleşik Krallık dışında yapılmış. Getty birincil telif iddialarını duruşma sırasında bırakmıştı; yalnızca erken çıktılardaki Getty filigranlarına ilişkin, dar kapsamlı bir marka ihlali bulundu. Temyiz izni Aralık’ta verildi (Bird & Bird). ABD ayağı Kaliforniya’da sürüyor. Andersen ve diğer sanatçıların Stability, Midjourney ve DeviantArt’a açtığı 2023 davası keşif aşamasında (CourtListener).
New York Times v. OpenAI. Aralık 2023’te açılan dava özet yargı aşamasında; 1 Eylül 2026’da ABD Adalet Bakanlığı, eğitim için kopyalamanın adil kullanım sayılabileceği yönünde bir “görüş beyanı” sundu; bu bir karar değil, hükümetin görüşü (AI Lawsuit Tracker). Davanın keşif aşamasında yaklaşık 20 milyon ChatGPT logunun istenmesi ise, kullanıcı sohbetlerinin hukuki delil olarak da bir “veri” olduğunu hatırlattı.
Suno ve Udio. RIAA’nın 24 Haziran 2024’te Universal, Sony ve Warner adına açtığı davalar, on altı ay içinde lisans anlaşmalarına dönüştü: Universal 29 Ekim 2025’te Udio ile uzlaştı; Warner, Ekim ve Kasım’da hem Udio hem Suno ile anlaştı. Sony, Udio’ya karşı davayı sürdürüyor; Universal ve Sony, Suno’ya karşı devam ediyor (AI Lawsuit Tracker). Müzik sektörünün cevabı “eğitmeyin” olmadı; “eğitin, ama lisansla” oldu.
Hollywood. 25 Eylül 2023’te yürürlüğe giren WGA sözleşmesi, yapay zekânın “edebi materyal” yazamayacağını ve “kaynak materyal” sayılmayacağını, şirketin yazarı yapay zekâ kullanmaya zorlayamayacağını, verilen materyalin yapay zekâ üretimi olduğunun ifşa edilmesi gerektiğini yazdı; sendika, yazar materyaliyle model eğitilmesinin yasak olduğunu ileri sürme hakkını saklı tuttu (Variety). SAG-AFTRA’nın 5 Aralık 2023’te onaylanan sözleşmesi, dijital replikalar için bilgilendirilmiş onay ve ücret şartı getirdi (SAG-AFTRA). Buckmaster’ın Bubeck’le konuşmasında istediği şey, özünde bir WGA maddesiydi: “Kaynak materyal benim; bunu böyle yazın.”
Cannes Lions. 2025 festivalinde Brezilyalı DM9’un Creative Data Grand Prix’i, vaka filminde yapay zekâyla üretilmiş ya da simüle edilmiş sonuçlar kullanıldığı ortaya çıkınca geri alındı. Festival zorunlu yapay zekâ ifşası, içerik tespit araçları ve etik komite getirdi; 12 Kasım 2025’te “LIONS Integrity Handbook” yayımlandı ve 2026’dan itibaren yanlış beyanda üç yıla kadar katılım yasağı geldi. 2026 girişlerinin yüzde 40’ı yapay zekâ kullandığını beyan etti (Campaign; Storyboard18). Reklam dünyasının en büyük ödül platformu, matematikçilerin Clay için istediği şeyi (kaynağın ve sürecin ifşası) kendi juri sistemine bir yıl önce yazdı.
Bu vakaların hiçbiri Navier–Stokes olayının birebir kopyası değil. Ama hepsi aynı soruyu, aynı yönde cevaplamış durumda: bir platforma verdiğin içeriğin ve davranışın, o platformun ürününü geliştirmek için kullanılıp kullanılmayacağı, teknik bir varsayılan olarak değil, müzakere edilmiş bir sözleşme maddesi olarak belirlenmek zorunda.
4. Ajans dünyasının cevabı: kapalı bahçe
Reklam holdingleri bu soruya, hukuk sistemlerinin ve ödül jürilerinin önünde cevap verdi. WPP, 2024’de WPP Open platformunu 28.000’den fazla çalışanına açtı; Ocak 2026’da Agent Hub‘ı eklerken “müşteri verisi gizli ve güvende kalır” ifadesini açıkça yazdı (WPP). Omnicom, IPG satın alımının ardından Omni platformunu Acxiom verisiyle güncelledi; Publicis’in Marcel’i 2018’den beri kapalı bir ekosistem (The Media Leader). Mantık aynı: müşterinin brief’i, kreatif yönü ve verisi holdingin duvarlarının içinde kalsın; sınır modellere yalnızca kontrollü kanallardan gitsin.
İroni burada. Aynı holdingler (WPP, Omnicom ve Dentsu), OpenAI’ın ChatGPT içinde reklam pilotunda ilk ajans ortakları olarak seçildiler (Adweek). Yani sektör, kendi fikirlerini OpenAI’dan korumak için kapalı bahçe kurarken, müşterilerinin reklamını OpenAI’ın bahçesine taşıyor. Bu bir çelişki değil; bir pazarlık pozisyonu. Ajans, platformla ilişkisini “kullanıcı” olarak değil “karşı taraf” olarak kuruyor.
Küçük ve orta ölçekli stüdyolar, bağımsız yaratıcı yönetmenler, freelance yazarlar ve yapımcılar için bu pozisyon lüks. Onlar Buckmaster’ın konumundalar: dünyanın en iyi araçlarına tüketici hesabıyla erişiyorlar ve o hesabın sözleşmesi, çalıştıkları malzemenin kaderini belirliyor.
Türkiye: rehber var, pratik yok
Kişisel Verileri Koruma Kurumu, bu tartışmanın Türkiye ayağı için üç belge yayımladı: Kasım 2024’te ChatGPT örneği üzerinden bir sohbet robotu bilgi notu, Nisan 2025’te “Yapay Zekâ Alanında Kişisel Verilerin Korunmasına Dair Tavsiyeler” ve 24 Kasım 2025’te “Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi (15 Soruda)” (KVKK rehberi hakkında). Rehber, üretken modellerin veri işleme faaliyetini 6698 sayılı Kanun çerçevesine oturtuyor: kim veri sorumlusu, kim veri işleyen, özel nitelikli veri nasıl ele alınır, yurt dışına aktarım hangi şartlarda mümkün.
Rehberin cevaplamadığı şey, yazıdaki sorumuz. KVKK kişisel veriyi korur; bir ajansın kreatif brief’i, bir stüdyonun senaryo taslağı ya da bir matematikçinin ispat stratejisi kişisel veri değildir. Bu malzemenin platforma emanet edildiğinde başına ne geleceği, veri koruma hukukunun değil, sözleşme hukukunun ve ticari sırrın alanına girer. Türkiye’de ajans ve stüdyo düzeyinde, çalışanların hangi yapay zekâ araçlarını hangi hesap tipiyle, hangi malzemeyle kullanabileceğini yazılı olarak düzenleyen kamuya açık bir kurumsal politika örneği bu araştırmada bulunamadı. Bu bir eksiklik tespiti değil; bir boşluk tespiti.
5. Karşı görüş: kullanıcı mı geçildi, iki platform mu birbirini geçti?
Bu yazının tezine en ilginç itiraz, olayın kendi içinden geliyor. Noam Brown, 17 Eylül’de Dwarkesh Patel’in programında sonucun çoklu ajan mimarisine atfedilmesine karşı çıktı: “I wouldn’t even attribute 10% of the credit to multi-agent.” Ona göre belirleyici olan, OpenAI’ın çok güçlü bir iç model eğitmiş olması. “On bin ajan” büyülü değilse, olay bir ölçek hikâyesi değil; o zaman platform çarkı argümanı da zayıflar mı? Tam tersi. Sonucu üreten şey ölçeklenebilir bir ajan sürüsü değil de yayımlanmamış bir iç modelse, o modele kimin erişebildiği ve o modelin neyle beslendiği sorusu daha da keskinleşiyor.
Beşinci ve en ilginç karşı argüman, Alpöge’nin Anthropic’te çalışmasının olayı bir “şirketler arası rekabet” hikâyesine çevirmesi. Buckmaster’ın aktardığı yazarlıktan çıkarma teklifi, bu okumayı besliyor: OpenAI’ın rahatsız olduğu şey bir NYU profesörünün önceliği değil, rakip bir laboratuvar çalışanının adının kendi sonucunun yanında durması olabilir. Bu doğruysa, Sherlocking sorusu da yer değiştiriyor: soru “platform kullanıcısını mı geçti” olmaktan çıkıp “iki platform birbirini kullanıcı üzerinden mi geçti” hâline geliyor. Buckmaster, iki şirketin arasında kalmış bir kullanıcı. Yaratıcı sektördeki karşılığı: bir reklam holdinginin kapalı bahçesinde çalışan bir ajans, o holdingin rakibinin sınır modeline hangi hesapla erişiyor?
Bu okuma tezi değiştirmiyor; ölçeğini büyütüyor. Sherlocking’in Watson versiyonunda tek bir platform vardı. Yapay zekâ versiyonunda birden fazla platform, aynı kullanıcı üzerinden birbirini görüyor ve kullanıcı, iki platformun arasında, sözleşmesini okumadığı bir hesapla duruyor.
6. Bu durumda ne yapıyorsun
Şimdi kapanış listesi değil; olayın pratik sonucu. Eğer fikrini, taslağını, stratejini bir yapay zekâ platformuna giriyorsan, Navier–Stokes olayının sana söylediği dört şey var.
Birincisi, hesap tipi bir ayar değil, bir sözleşmedir. Tüketici hesabı ile iş hesabı arasındaki fark, arayüzde bir düğme; hukuken ise iki farklı veri rejimi. Project Lily’nin anlattığı mekanizmaların hiçbiri, verinin eğitimde kullanılmadığı kurumsal katmanlar için geçerli değil. Yayımlanmamış, rekabetçi değer taşıyan her iş için hesap tipini ona göre seç; ekipteki herkesin hangi hesapla çalıştığını bil.
İkincisi, kapatma düğmesi geriye işlemez. “Modeli iyileştir” seçeneğini bugün kapatmak, dünkü sohbeti havuzdan çıkarmıyor. Karar, malzemeyi girmeden önce verilir.
Üçüncüsü, kimlik değil, yöntem sızar. Privacy Filter isimleri siler; kreatif yönü, senaryo yapısını, ispat stratejisini silmez. Malzemenin “hassas” olup olmadığına kişisel veri içerip içermediğine göre değil, rekabetçi değer taşıyıp taşımadığına göre karar ver.
Dördüncüsü, önceliği zaman damgasıyla kur. Buckmaster’ın elindeki en güçlü kanıt, 22 Ağustos’ta hazır olan Lean doğrulamalı kanıttı; 7 Eylül’de açıklanabildi. Yaratıcı işte bunun karşılığı, brief’in, tretmanın, konseptin tarihli ve üçüncü tarafça doğrulanabilir bir kaydını platforma girmeden önce oluşturmak. Bu bir güvensizlik jesti değil; WGA’nın “kaynak materyal” maddesinin bireysel versiyonu.
On iki saatin diğer yüzü
7 Eylül gece yarısına dakikalar kala, bir matematikçi aylardır bir platformun içinde yürüdüğü yolun sonuna vardı ve sonucunu açıkladı. On iki saat sonra, o platformun sahibi aynı yolun bir sonraki durağına 88 saatte vardığını açıkladı. Şirket, iki yol arasında hiçbir bağ olmadığını iç soruşturmasıyla doğruladı. Bunun aksini gösteren hiçbir kanıt yok; bunu dışarıdan doğrulayacak hiçbir mekanizma da yok.
Yaratıcı sektör için Navier–Stokes’un anlamı, akışkanların tekilliğinde değil, bu cümlede. İstanbul’daki ajansın konkuru ile Buckmaster’ın ön baskısı arasındaki tek fark, birinin 22 Ağustos tarihli bir kaydının olması. Prompt’un bir girdi olduğu dönem, Buckmaster’ın Codex oturumlarıyla birlikte bitti. Bundan sonra prompt, bir profesyonelin en değerli ürünü: yöntemi. Ve o ürünü kime, hangi sözleşmeyle, hangi zaman damgasıyla verdiği, işinin sonucunu belirleyecek.
Jobs’un Dan Wood’a söylediği benzetme yirmi dört yıl sonra da geçerli. Rayların sahibi lokomotiftir. Fark şu ki artık raylar, üzerinde yürüyenin nereye gittiğini de kaydediyor.
Kaynaklar
- On the Navier–Stokes Millennium Prize Problem — OpenAI (8 Eylül 2026, 10 Eylül güncellemesi)
- Finite time blowup with smooth forcing term… — Terence Tao (7 Eylül 2026)
- OpenAI’s historic math solution overshadowed by credit controversy — Axios (8 Eylül 2026)
- Inside ‘Project Lily’: The Humans Reading Your ChatGPT Chats — 404 Media (14 Eylül 2026)
- OpenAI Hired Contractors To Review ChatGPT Chats… — IBTimes UK
- ChatGPT transcripts are reportedly read by humans… — Tom’s Hardware
- The Meaning of the Term “Sherlocking” — 512 Pixels
- What Does It Mean When Apple “Sherlocks” an App? — How-To Geek
- Everything Apple Sherlocked in macOS Ventura, iOS 16 — AppleInsider
- Amazon scooped up data from its own sellers — WSJ aktarımı, Fox Business (Nisan 2020)
- Bezos ‘can’t guarantee’ policy against using seller data hasn’t been violated — VentureBeat (29 Temmuz 2020)
- Zoom CEO admits mistake as terms-of-service changes raise AI fears — Axios (9 Ağustos 2023)
- User Outcry as Slack Scrapes Customer Data for AI Model Training — SecurityWeek (Mayıs 2024)
- Adobe’s Updated Terms of Service and Stance on AI — No Film School (Haziran 2024)
- Figma explains why AI kept making copies of Apple’s Weather app — 9to5Mac (Temmuz 2024)
- Stability AI defeats Getty Images copyright claims — Bird & Bird (Kasım 2025)
- Andersen v. Stability AI Ltd., 3:23-cv-00201 — CourtListener
- New York Times v. OpenAI & Microsoft — AI Lawsuit Tracker
- UMG v. Suno (and Udio) — AI Lawsuit Tracker
- New WGA Contract Explained — Variety (Eylül 2023)
- SAG-AFTRA A.I. Bargaining and Policy Work Timeline — SAG-AFTRA
- Jurors pull back the curtain on Cannes Lions’ new integrity era — Campaign
- Cannes Lions withdraws Grand Prix after discovery of AI-faked case film — Storyboard18
- WPP launches Agent Hub on WPP Open — WPP (Ocak 2026)
- Agency groups’ AI platforms, explained — The Media Leader
- ChatGPT Gets Ads: Omnicom, WPP, and Dentsu Line Up Brands for OpenAI Pilot — Adweek
- Enterprise privacy at OpenAI — OpenAI
- Updates to Consumer Terms and Privacy Policy — Anthropic (28 Ağustos 2025)
- Üretken Yapay Zekâ ve Kişisel Verilerin Korunması Rehberi (15 Soruda), 24 Kasım 2025 — SRP-Legal aktarımı